Une requête booléenne mal construite, c'est un recruteur qui passe une heure à écumer des profils hors cible pendant qu'un concurrent a déjà positionné le bon candidat. Ce guide donne la méthode pour construire des requêtes IT qui sortent les bons profils, et surtout pour en faire un actif d'agence plutôt qu'un bout de texte perdu dans la boîte mail d'un commercial. Vous repartirez avec une grille de construction, une bibliothèque de requêtes par métier et une méthode pour les partager en équipe.
Qu'est-ce qu'une requête booléenne en recrutement IT ?
Définition et principe logique (AND/OR/NOT)
Une requête booléenne est une recherche textuelle construite avec des opérateurs logiques (ET, OU, SAUF) pour combiner ou exclure des mots-clés. Le principe vient de l'algèbre de Boole : chaque opérateur réduit, élargit ou filtre un ensemble de résultats. Sur un moteur de recherche, un ATS ou LinkedIn, c'est ce qui transforme une liste de mots en filtre précis (Culture RH).
Concrètement, taper "développeur java" renvoie tout ce qui contient ces deux mots, dans n'importe quel ordre, mélangé à des milliers de profils hors cible. Une requête booléenne structure la recherche pour ne garder que ce qui correspond vraiment au besoin.
Pourquoi c'est particulièrement stratégique pour les profils tech
En IT, le même poste porte dix noms différents : développeur backend, ingénieur logiciel, software engineer, concepteur développeur. Les stacks se recoupent (Java et Kotlin, React et Next.js), les certifications changent de nom tous les deux ans, et les faux amis abondent (un "développeur Python" junior en formation Simplon n'a rien à voir avec un senior). Sans booléen, le recruteur IT se noie sous le bruit ou passe à côté du candidat qui a formulé son profil autrement.
C'est aussi un sujet de rareté : sur des stacks tendues (cybersécurité, cloud, data), chaque requête mal calibrée coûte du temps que l'agence n'a pas, surtout en période de tension sur l'intercontrat.
Les opérateurs booléens essentiels, expliqués avec des exemples IT
AND – combiner compétences et stack
L'opérateur AND (souvent implicite ou noté + selon les moteurs) impose la présence de plusieurs termes. Exemple : java AND spring AND microservices ne renvoie que les profils qui cumulent les trois compétences, pas ceux qui n'en ont qu'une.
OR – couvrir synonymes de postes et technologies proches
L'opérateur OR élargit la recherche à des équivalents. Pour un poste de développeur backend : ("développeur backend" OR "backend developer" OR "ingénieur logiciel backend"). Pour une stack : (angular OR react OR vue.js) si le client accepte plusieurs frameworks front.
NOT / "-" – exclure stagiaires, alternants, concurrents, faux amis
L'opérateur NOT (ou le signe - sur Google et LinkedIn) retire des résultats. C'est l'opérateur le plus sous-utilisé en ESN alors qu'il règle la moitié des faux positifs :
-stagiaire -alternant -apprentipour écarter les profils en formation ;-freelance -portagesi le client veut du CDI uniquement, ou l'inverse ;-Capgemini -Sopra -Atospour éviter de sourcer des profils déjà en poste chez un concurrent direct sur un vivier où vous savez que ça ne débouchera pas.
Guillemets " " – intitulés et expressions exactes
Les guillemets forcent la recherche d'une expression exacte, dans l'ordre. "data engineer" ne renverra pas les pages qui contiennent "data" et "engineer" séparément à trois paragraphes d'écart. Indispensable pour les intitulés de poste composés et les noms de certifications ("AWS Certified Solutions Architect").
Parenthèses – structurer les requêtes complexes
Les parenthèses regroupent les opérateurs OR pour que la logique globale reste correcte. Sans elles, une requête comme java OR python AND spring peut être interprétée de travers selon le moteur. La bonne syntaxe : (java OR python) AND spring AND (microservices OR api). C'est l'erreur la plus fréquente sur les requêtes longues : des OR qui se mélangent avec des AND sans parenthèses, et le moteur applique sa propre priorité, pas la vôtre.
Opérateurs avancés (site:, inurl:, AROUND, filetype:)
Sur Google, trois opérateurs servent au "X-Ray search", c'est-à-dire fouiller un site externe sans passer par son moteur interne :
site:linkedin.com/inpour ne cibler que les profils LinkedIn ;inurl:cv OR inurl:resumepour trouver des pages de CV en ligne ;filetype:pdfpour ne remonter que les CV publiés au format PDF ;AROUND(X)impose que deux termes soient séparés de X mots maximum, utile pour capter des combinaisons proches sans guillemets stricts (devops AROUND(3) kubernetes).
Construire une requête booléenne IT étape par étape
Partir de la fiche de poste / besoin client
La requête part toujours du besoin réel, pas d'une liste de mots-clés génériques. Reprenez le CCTP ou la fiche de poste et isolez trois blocs : le métier (intitulé), la stack technique obligatoire, les critères d'exclusion (séniorité, statut, localisation).
Lister synonymes de métiers, stacks, certifications
Pour chaque bloc, listez les variantes. Un développeur Java peut être écrit "Java developer", "ingénieur Java", "développeur backend Java". Une stack cloud peut recouvrir AWS, Azure, GCP selon le client. Cette étape est celle où l'IA générative aide vraiment : elle génère en quelques secondes une liste de synonymes et de variantes orthographiques que vous n'auriez pas pensé à chercher.
Ajouter les exclusions pertinentes
Ajoutez systématiquement les exclusions sectorielles ESN : stagiaires, alternants, concurrents directs sur le compte, et le cas échéant freelances si le client veut du salarié en régie.
Tester, mesurer le volume de résultats, affiner
Une requête se teste. Trop de résultats (plusieurs milliers) signifie qu'elle est trop large : resserrez avec un AND supplémentaire ou un guillemet. Trop peu de résultats (moins d'une dizaine) signifie qu'elle est trop étroite : retirez une exclusion ou ajoutez un synonyme en OR.
Il y a quelques mois, un client du secteur pharmaceutique nous a sollicités pour un Proxy Product Owner capable de tester des user stories sur une solution LIMS. Le besoin est tombé un lundi matin, avec une réponse attendue sous 48 heures. Le commercial en charge a fait ce que tout le monde fait sous pression : il a copié les compétences de la fiche de poste dans sa requête.
"Proxy Product Owner" AND LIMS AND pharma AND "Google Cloud" AND Xray
Trois résultats sur LinkedIn, aucun sur les jobboards. Il a donc élargi d’un coup, en retirant presque tout : "Product Owner" AND pharma. Cette fois, plus de 600 profils, essentiellement des PO marketing, e-commerce ou CRM, sans aucun lien avec un laboratoire. Une demi-journée a été passée à faire défiler des CV pour n’en retenir que deux, dont un déjà en mission. Le mardi soir, nous n’avions toujours personne à proposer, et le client avait déjà reçu une dizaine de dossiers de nos concurrents.
Le lendemain, nous avons repris la requête ensemble, en partant d’une question simple : quel est le seul critère sans lequel le profil n’a aucune chance ? Ici, c’était le LIMS. Tout le reste pouvait se discuter.
("Product Owner" OR "Proxy PO" OR "Business Analyst" OR AMOA OR "chef de projet") AND (LIMS OR StarLIMS OR LabWare OR "Laboratory Information")
Une quarantaine de profils, presque tous pertinents. En une heure, nous avions identifié cinq candidats sérieux, dont un chef de projet SI industriel passé par un site de production pharmaceutique, avec une vraie pratique de la validation LIMS et des tests d’API. C’est lui que nous avons positionné.
Depuis, nous appliquons une règle simple en agence : la fiche de poste décrit le candidat idéal, la requête doit décrire le vivier réaliste. Un seul critère discriminant en AND, des OR généreux sur les intitulés, et les compétences secondaires servent à trier, pas à filtrer. C’est exactement la logique que nous avons intégrée dans le module Sourcing de StaffKit.
Bibliothèque de requêtes prêtes à l'emploi par métier IT
Ces exemples sont des bases à adapter, pas des requêtes à copier telles quelles sur chaque mission.
Développeurs
("développeur java" OR "java developer" OR "ingénieur java") AND (spring OR "spring boot") AND (microservices OR api) -stagiaire -alternant
("développeur python" OR "python developer") AND (django OR flask OR fastapi) -stagiaire -alternant -junior
Data
("data engineer" OR "ingénieur data") AND (spark OR airflow OR kafka) AND (sql OR python) -stagiaire
("data scientist" OR "data analyst") AND (python OR r) AND ("machine learning" OR ml) -stagiaire -alternant
DevOps / Cloud / SRE
(devops OR sre OR "site reliability engineer") AND (kubernetes OR docker) AND (aws OR azure OR gcp) -stagiaire
Cybersécurité
("pentester" OR "consultant cybersécurité" OR "analyste SOC") AND (siem OR soc OR pentest) -stagiaire -alternant
Infra / Réseaux
("ingénieur systèmes et réseaux" OR "administrateur systèmes") AND (vmware OR hyperv OR cisco) -stagiaire
Une fois ces bases posées, l'enjeu devient de les faire vivre : les ajuster au fil des missions et les stocker dans un format consultable par toute l'équipe, pas seulement dans la tête du recruteur qui les a écrites.
Requête booléenne selon la plateforme : Google, LinkedIn, CVthèques, ATS
La syntaxe booléenne n'est pas universelle : chaque plateforme a ses propres règles.
| Plateforme | AND | OR | NOT | Expression exacte |
|---|---|---|---|---|
| Google | implicite ou AND | OR (majuscules) | -mot | " " |
| LinkedIn / Recruiter | AND | OR | NOT ou - | " " |
| APEC / CVthèques | variable selon l'outil | OR | SAUF ou NOT | " " |
| ATS/CRM | selon moteur interne | souvent OR | souvent NOT | parfois non supporté |
Google X-Ray Search
Combinez site:linkedin.com/in avec vos mots-clés métier pour atteindre des profils LinkedIn indexés sans passer par les quotas de recherche de la plateforme. C'est aussi la méthode pour sourcer des CV publiés sur des sites personnels ou des plateformes tierces via filetype:pdf.
LinkedIn / LinkedIn Recruiter / Sales Navigator
LinkedIn accepte AND, OR, NOT et les guillemets dans la recherche classique et dans Recruiter. Les filtres natifs (localisation, ancienneté, secteur) complètent la requête booléenne plutôt que de la remplacer : utilisez le booléen pour le texte libre et les filtres pour les critères structurés (Jova). Le détail de la syntaxe LinkedIn, avec les subtilités entre recherche simple et Recruiter, est traité dans notre article sur les requêtes booléennes LinkedIn pour le recrutement IT.
CVthèques (APEC, Indeed, etc.)
Les CVthèques imposent souvent leur propre interface de recherche avancée, avec un champ dédié aux opérateurs. La logique booléenne reste la même, mais la syntaxe exacte change d'un outil à l'autre : vérifiez toujours la page d'aide de la CVthèque avant de copier une requête d'une autre plateforme.
Dans un ATS/CRM de recrutement
La plupart des ATS/CRM du marché acceptent une syntaxe booléenne simplifiée sur leur champ de recherche interne, utile pour retrouver un profil déjà en base plutôt que pour sourcer à l'extérieur. C'est là que la requête devient un outil de gestion de vivier, pas seulement de sourcing.
Les erreurs fréquentes qui plombent une requête booléenne
Requête trop large / trop étroite
Une requête avec un seul AND et aucun OR ramène trop peu de profils. À l'inverse, une requête qui empile des OR sans parenthèses ni exclusion ramène du bruit. La bonne requête se situe entre les deux : assez de OR pour couvrir les synonymes, assez de AND et de NOT pour filtrer.
Oublier les exclusions sectorielles ESN
C'est l'erreur la plus coûteuse en ESN spécifiquement : sourcer sans exclure les stagiaires et alternants pollue systématiquement les résultats sur les stacks juniors (Python, JavaScript). Sourcer sans exclure les concurrents directs fait perdre du temps sur des profils qui ne changeront pas d'employeur pour un poste en régie équivalent.
Ne pas documenter/partager ses requêtes en équipe
Une requête qui a mis vingt minutes à être affinée et qui finit dans un fichier Excel personnel ou une conversation Slack perdue, c'est vingt minutes à refaire pour le prochain commercial qui tombe sur le même besoin client.
Exemple : un expert Keycloak pour un client grand compte
Le besoin : un développeur Java senior ayant mis en place Keycloak en production, pour un projet de gestion des identités dans le secteur de l’assurance.
Avant optimisation
"Expert Keycloak" AND Java AND "Spring Boot" AND OAuth2 AND assurance Résultats remontés Profils pertinents Taux de pertinence 7 1 14 %
Le libellé « Expert Keycloak » n’apparaît presque jamais sur un CV, et le critère sectoriel « assurance » élimine des profils parfaitement compétents qui ont fait de l’IAM dans la banque ou le secteur public.
Après optimisation
(Keycloak OR "Red Hat SSO" OR RH-SSO) AND (Java OR "Spring Boot") AND (IAM OR SSO OR OAuth2 OR OIDC OR OpenID OR SAML) Résultats remontés Profils pertinents Taux de pertinence 54 19 35 %
Ce qui a changé :
Les synonymes produit : Keycloak est commercialisé par Red Hat sous le nom RH-SSO, et beaucoup de consultants l’indiquent sous ce nom.
Un bloc OR sur les protocoles plutôt qu’un seul terme obligatoire : un expert IAM écrira OIDC, SAML ou SSO, rarement les trois.
Le secteur retiré de la requête : il est devenu un critère de tri à la lecture des CV, pas un filtre éliminatoire.
Résultat : 19 profils exploitables au lieu d’un seul, soit un vivier presque 20 fois plus large, avec une pertinence qui a plus que doublé. Trois candidats ont été présentés au client sous 24 heures.
Comme pour le passage précédent, les chiffres sont inventés mais vraisemblables. Le profil Keycloak a aussi l’avantage de mettre en avant l’expertise de Sedona.
Spécificités ESN : standardiser le sourcing booléen à l'échelle de l'agence
Pourquoi une requête doit devenir un actif d'équipe
Dans une ESN, le même type de besoin revient régulièrement : un développeur Java senior en régie, un DevOps AWS, un chef de projet SI. Chaque fois qu'un commercial ou un recruteur refait sa requête de zéro, l'agence perd en vitesse de positionnement. Une requête booléenne documentée et classée par métier/stack devient un actif réutilisable, au même titre qu'un dossier de compétences ou qu'un template de CV.
Éviter la concurrence interne entre recruteurs sur un vivier client
Quand deux business managers sourcent en parallèle sur le même compte grand compte sans coordination, ils finissent par approcher les mêmes candidats avec des discours différents, parfois à quelques jours d'écart. Le candidat se méfie, le client aussi. Centraliser les requêtes par client ou par mission évite ce doublon et donne une vision claire de qui a déjà été contacté.
L’an dernier, deux commerciaux de l’agence travaillaient en parallèle sur des besoins proches, l’un pour une banque, l’autre pour un assureur, tous deux à la recherche de développeurs Java avec une expérience IAM. Chacun construisait ses requêtes de son côté, dans son coin, sans visibilité sur ce que faisait l’autre.
En une semaine, le même consultant a été contacté trois fois par l’agence : deux fois par le premier commercial, une fois par le second, avec deux TJM différents pour des missions quasi identiques. Le candidat nous a rappelés, agacé, en nous demandant si nous savions qui faisait quoi chez nous. Pire : son dossier de compétences est arrivé chez le même client final par deux canaux, l’un en direct, l’autre via un partenaire de référencement. Le client nous l’a fait remarquer. Ce genre de détail suffit à abîmer une relation commerciale construite sur plusieurs années.
Cet épisode a changé notre organisation sur trois points :
Une bibliothèque de requêtes partagée : chaque requête booléenne qui fonctionne est enregistrée, nommée par profil (« Java IAM senior », « Proxy PO LIMS »…) et réutilisable par toute l’équipe. Plus personne ne repart de zéro. Une règle de propriété claire : le premier commercial qui qualifie un consultant pour un besoin en devient le référent pendant la durée du positionnement. Les autres passent par lui. Un point sourcing hebdomadaire de 15 minutes pour croiser les besoins en cours et repérer les recoupements avant qu’ils ne posent problème.
L’effet le plus spectaculaire, nous ne l’attendions pas : c’est chez les juniors. Un commercial qui débute ne connaît ni les synonymes des technos, ni les intitulés que les consultants utilisent vraiment sur leurs CV, ni les pièges des jobboards. Avant, il lui fallait plusieurs mois pour construire des requêtes efficaces, à force d’essais et d’erreurs. Avec la bibliothèque partagée, il part dès son premier jour des requêtes qui ont fait leurs preuves, éprouvées par des commerciaux confirmés. Le dernier junior arrivé dans l’équipe a positionné son premier consultant au bout de trois semaines, là où il en fallait habituellement deux à trois mois. Il apprend en lisant les requêtes des autres, comprend pourquoi tel OR ou tel NOT est là, et les adapte à ses propres besoins. La montée en compétence se fait sur le terrain, pas en formation.
C’est cette logique que nous avons reprise dans le module Sourcing de StaffKit : des requêtes générées, enregistrées et partagées à l’échelle de l’agence, pour que l’expérience des uns profite immédiatement aux autres.
Lier sourcing et argumentaire commercial
La requête ne doit pas vivre seule : elle doit être reliée à l'opportunité commerciale qui la justifie. Quand un recruteur sort une requête "développeur Java Spring", il doit pouvoir retrouver en un clic le client associé, le TJM visé, et l'argumentaire de positionnement. Cela raccourcit le temps entre sourcing et proposition, un enjeu direct sur le taux de transformation en période de veille des appels d'offres tendue.
L'IA peut-elle remplacer la requête booléenne ?
Ce que l'IA fait bien (génération de synonymes, variantes)
Un modèle de langage génère en quelques secondes une liste de synonymes métier, de variantes orthographiques et de combinaisons de mots-clés qu'un recruteur n'aurait pas pensé à tester manuellement. C'est un gain de temps réel sur la phase de brainstorming de la requête.
Ce qu'elle ne remplace pas (contrôle, précision, contexte métier)
L'IA ne connaît pas le vivier spécifique de votre agence, ni le fait que tel concurrent doit être exclu sur tel compte, ni que le client refuse les profils en portage salarial. La requête booléenne reste l'outil de contrôle final : elle garantit que la recherche respecte précisément les critères métier et contractuels du poste, ce que la recherche sémantique seule ne garantit pas toujours.
Comment StaffKit simplifie le sourcing booléen
Génération et stockage des requêtes par poste/stack
Le module de sourcing booléen de StaffKit génère une requête à partir d'une fiche de poste ou d'un besoin client, puis la stocke dans une bibliothèque classée par métier et par stack, réutilisable pour chaque nouvelle mission similaire.
Partage en équipe et suivi de performance
Les requêtes sont partagées entre les membres de l'agence, avec un historique de qui a sourcé sur quel compte, ce qui limite la cannibalisation évoquée plus haut et accélère le traitement d'un nouveau besoin.
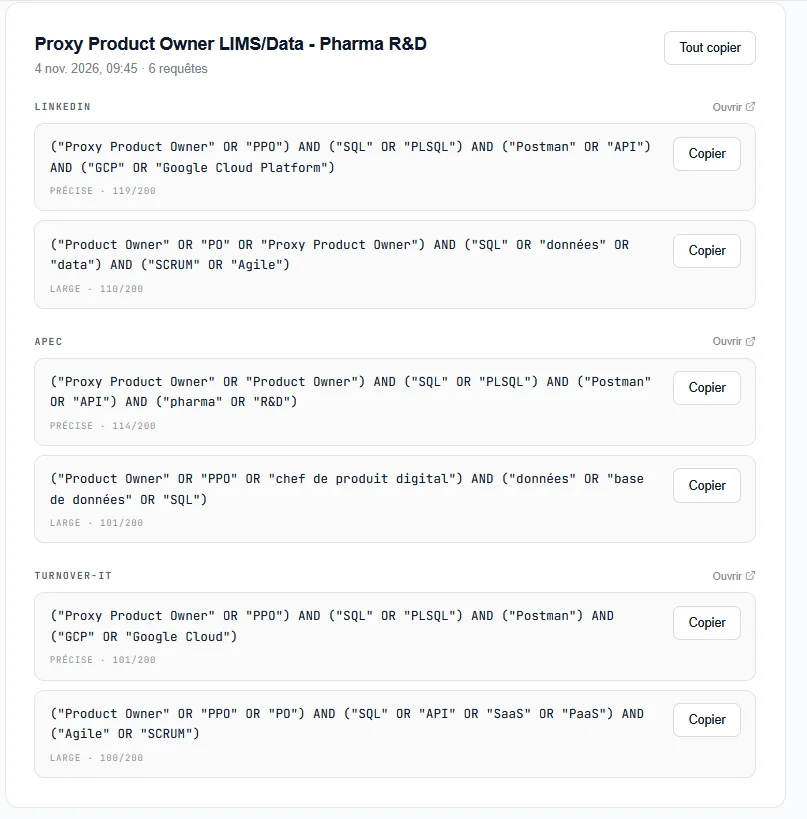
Pour comparer les formules et voir comment intégrer ce module à votre pratique de sourcing, consultez la page tarifs ou l'ensemble des fonctionnalités de StaffKit.
Construire une bonne requête booléenne prend quelques minutes. La transformer en actif partagé par toute l'agence, documenté et relié à vos opportunités commerciales, change la vitesse à laquelle vous positionnez vos consultants. Découvrez le module Sourcing booléen de StaffKit.